Donner à une intelligence artificielle les identifiants administrateur d’un site WordPress et lui demander de « gérer le contenu » est techniquement possible. C’est aussi une manière assez primitive d’aborder le problème.
Chez Lux Kybernetica, nous avons choisi une architecture différente : l’agent ne reçoit pas les clés de WordPress. Il reçoit uniquement les pouvoirs dont il a réellement besoin.
Une passerelle plutôt qu’un accès total
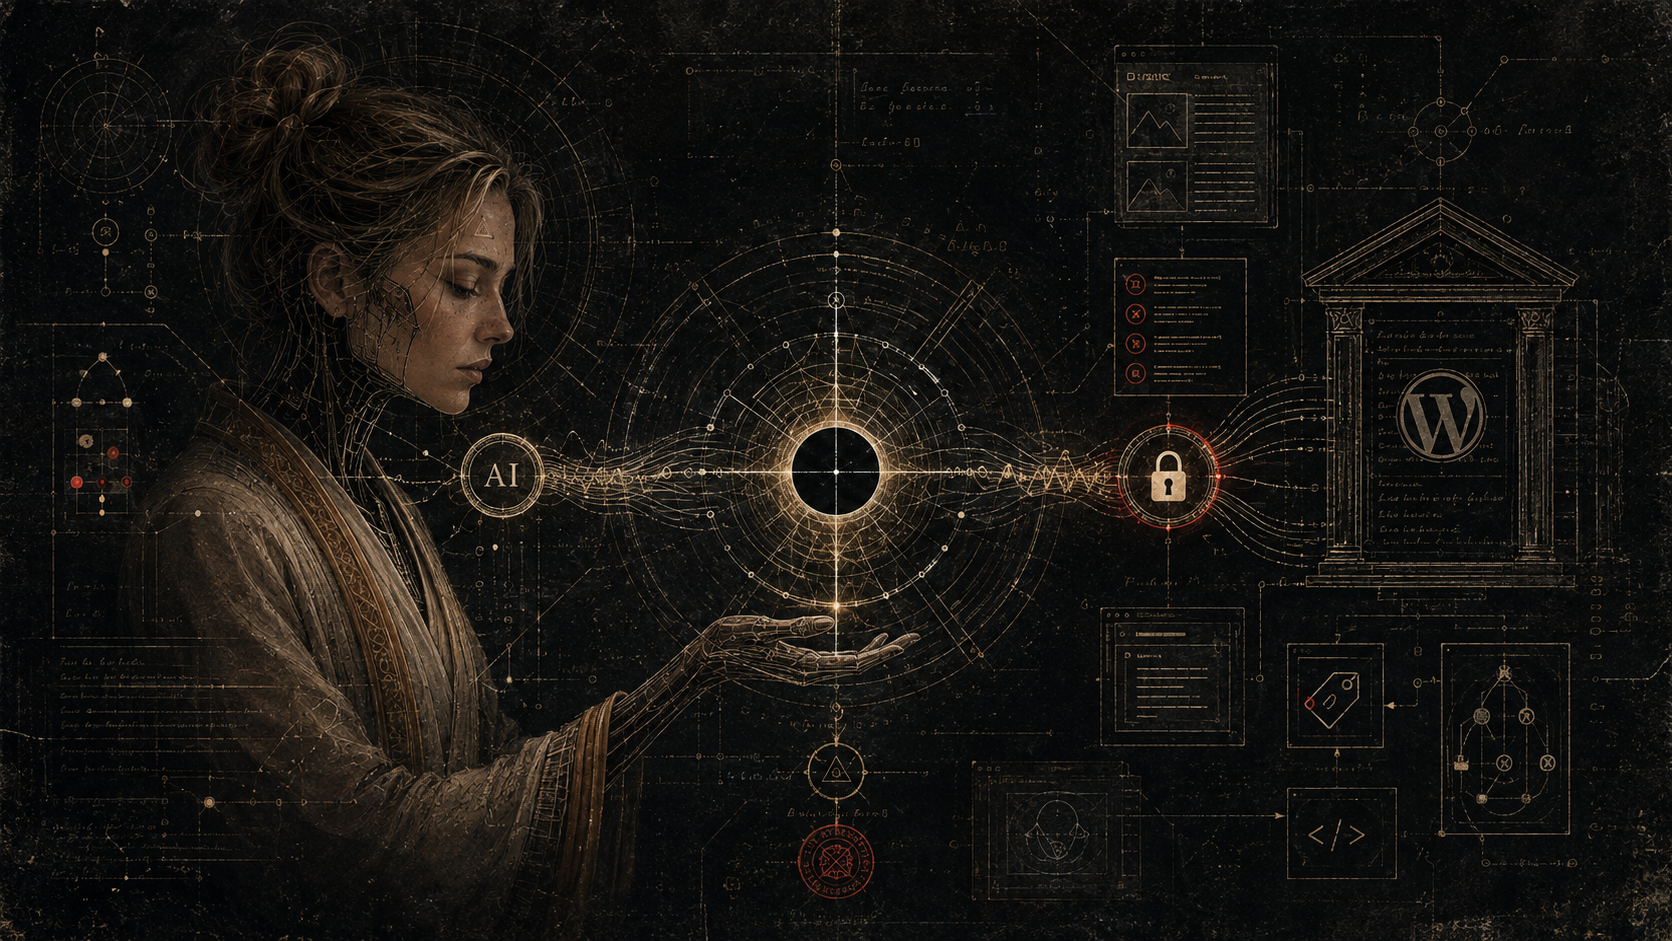
Le principe repose sur une passerelle éditoriale dédiée, le Lux WordPress Bridge. WordPress expose ainsi un ensemble restreint d’actions destinées aux agents : créer un brouillon, le relire, le modifier, lui attribuer des métadonnées, ajouter une image à la une, l’envoyer à la corbeille ou le restaurer.
Une chose manque volontairement à cette liste : publier.
L’agent peut donc préparer un article presque entièrement, mais la décision finale de mise en ligne reste humaine. Ce détail change profondément la nature du système : l’automatisation assiste la gouvernance éditoriale au lieu de la remplacer.
MCP comme langage commun
Au-dessus de cette passerelle, nous avons ajouté un serveur MCP, pour Model Context Protocol. Son intérêt est de découpler l’infrastructure WordPress du modèle d’intelligence artificielle utilisé.
Claude Code est actuellement notre premier client réel, mais il n’est pas inscrit en dur dans l’architecture. Un autre agent compatible MCP pourra utiliser les mêmes outils sans qu’il soit nécessaire de reconstruire toute la chaîne.
Autrement dit, nous ne construisons pas une « intégration Claude ». Nous construisons une interface entre des agents et notre système éditorial.
Le chemin réel d’une requête
Lorsqu’un agent veut créer un article, la requête suit aujourd’hui cette chaîne :
Agent IA → MCP → connexion SSH sécurisée → serveur Lux → WordPress Bridge → WordPress.
Le mot de passe d’application WordPress reste stocké sur le serveur. Il n’est ni fourni au modèle, ni conservé dans la configuration locale du client IA.
La connexion entre la machine de travail et le serveur utilise par ailleurs une clé SSH dédiée. L’agent peut donc appeler ses outils sans connaître les secrets qui rendent ces appels possibles.
Des pouvoirs limités et vérifiables
Nous avons testé l’ensemble du cycle éditorial sur une préproduction séparée du site public.
Un agent a ainsi pu créer un brouillon, le relire, modifier son contenu et son slug, l’envoyer à la corbeille, le restaurer puis lui attribuer une image à la une avec ses métadonnées.
À chaque étape, l’article est resté un brouillon.
Cette distinction peut sembler modeste, mais elle illustre une idée importante : un bon système d’agents n’a pas besoin de donner le maximum de permissions au modèle. Il doit au contraire lui fournir un ensemble de capacités explicites, limitées et observables.
Automatiser sans abandonner le gouvernail
Le fantasme courant autour des agents autonomes consiste à imaginer une IA capable de tout faire seule. Nous trouvons plus intéressante une autre direction : construire des systèmes dans lesquels humains et agents disposent chacun d’un rôle bien défini.
L’intelligence artificielle peut produire, transformer, classer et préparer. L’infrastructure contrôle ce qu’elle a le droit de faire. Et l’humain conserve les décisions qui engagent réellement le système.
Ce n’est pas une automatisation moins ambitieuse. C’est une automatisation gouvernée.
Et c’est probablement là que commencent les outils réellement utilisables : non pas quand une IA peut tout faire, mais quand on sait précisément ce qu’on accepte de la laisser faire.
Laisser un commentaire